Task: 3D Object Detection from LiDAR Point Clouds
Method: Pillar-based Point Cloud Encoding + 2D CNN Detection
Venue: CVPR 2019
Year: 2019
Paper: https://arxiv.org/abs/1812.05784
Code: https://github.com/nutonomy/second.pytorch
摘要
点云中的 3D 目标检测是自动驾驶的核心任务。本文提出 PointPillars,一种基于柱体(pillars)编码的 LiDAR 点云检测方法。该方法将点云沿 z 轴组织为垂直柱体,用简化版 PointNet 对每个柱体进行特征学习,生成 2D 伪图像(pseudo-image),随后用标准 2D CNN 骨干网络和 SSD 检测头进行 3D 目标检测。PointPillars 在 KITTI 基准测试上以 62 Hz 的推理速度达到 SOTA 性能(BEV mAP 66.19),比 VoxelNet 快 14 倍,同时在所有类别上性能更优。更快的版本可在 105 Hz 下达到接近 SOTA 的性能。
核心论点:将 3D 点云编码从体素化+3D 卷积简化为柱体化+2D 卷积,消除了昂贵的 3D 卷积瓶颈,在保持检测精度的同时实现了 10 倍以上的推理加速。
问题与动机
LiDAR 点云 3D 检测的现有方案存在速度与精度的矛盾:
| 方法类型 | 代表作 | 速度 | 核心问题 |
|---|---|---|---|
| 3D 卷积 | VoxelNet | 4.4 Hz | 3D 卷积计算量巨大 |
| 稀疏 3D 卷积 | SECOND | 20 Hz | 仍需 3D 卷积层 |
| 固定编码 | MV3D, PIXOR | 2.8-35 Hz | 手工特征不可学习,泛化差 |
| 视锥点云 | F-PointNet | 5.9 Hz | 依赖 2D 检测,多阶段 |
核心痛点:VoxelNet 验证了端到端学习的有效性,但 3D 卷积是推理速度的瓶颈(编码器耗时 190ms)。能否用纯 2D 运算替代 3D 卷积,同时保持端到端学习的优势?
核心洞察
洞察 1:柱体替代体素——消除 z 轴离散化
传统做法:VoxelNet 将点云离散为 3D 体素
本文做法:PointPillars 将点云按 x-y 平面离散为柱体(pillars)——即不限制 z 轴的无限高垂直柱。每个柱体内的点通过 PointNet 聚合后,直接散射(scatter)回 2D 伪图像。
其中
洞察 2:学习编码优于固定编码
传统做法:MV3D、PIXOR 等方法对每个网格单元使用手工设计的特征(如高度统计、密度等),不可学习。
本文做法:用简化 PointNet(单层线性+BN+ReLU+MaxPool)端到端学习柱体特征。关键在于每个点被增强为 9 维特征
消融实验证实:在相同下游网络下,学习编码比所有固定编码高约 1-5 mAP,且优势随网格尺寸增大而更明显。
洞察 3:2D 伪图像 + 标准 2D 检测管线 = 实时 3D 检测
传统做法:VoxelNet 在编码后仍需 3D 中间层处理体素特征,编码器耗时 190ms。
本文做法:柱体特征直接散射为 2D 伪图像
三个关键数字:
- 62 Hz:PointPillars 标准版在 KITTI 上的推理速度(VoxelNet 为 4.4 Hz)
- 1.3 ms:柱体编码器耗时(VoxelNet 编码器 190ms,SECOND 编码器 48ms)
- 66.19 mAP:KITTI test BEV 检测 mAP(超越所有 LiDAR-only 和大部分融合方法)
方法设计
4.1 整体架构
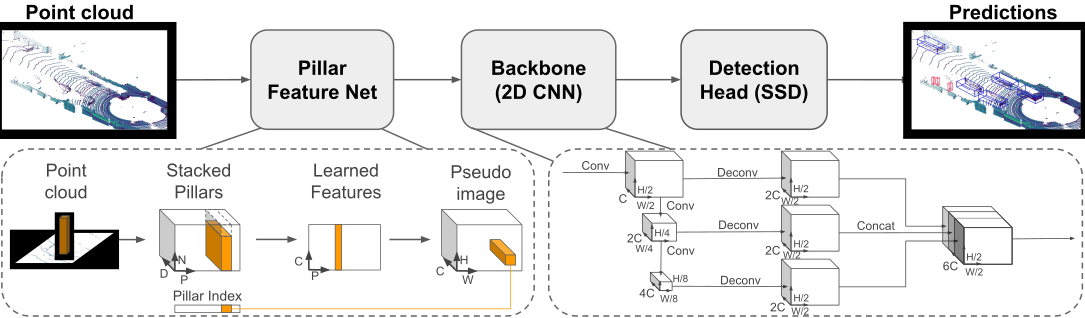
 Point Cloud (x,y,z,r)
           │
           ▼
┌──────────────────────────────┐
│   Pillar Feature Net         │
│  1. 柱体化 → (D=9, P, N)      │
│  2. Linear(9→64)+BN+ReLU     │
│  3. Max over N → (C=64, P)   │
│  4. Scatter → (64, H, W)     │
└──────────┬───────────────────┘
           ▼
┌──────────────────────────────┐
│   2D Backbone (类 VoxelNet)  │
│  Block1(S,4,C) → Up1(S,S,2C) │
│  Block2(2S,6,2C)→Up2(2S,S,2C)│
│  Block3(4S,6,4C)→Up3(4S,S,2C)│
│  Concat → (6C, H/S, W/S)     │
└──────────┬───────────────────┘
           ▼
┌───────────────────────────────┐
│   SSD Detection Head          │
│  分类: Focal Loss              │
│  回归: SmoothL1 (x,y,z,w,l,h,θ)│
│  方向: Softmax 方向分类         │
│  NMS: 2D IoU 阈值 0.5          │
└──────────┬────────────────────┘
           ▼
    3D Bounding Boxes (x,y,z,w,l,h,θ)
4.2 关键组件
| 组件 | 规格 | 功能 | 损失权重 |
|---|---|---|---|
| Pillar Feature Net | (9→64), MaxPool | 柱体内点特征聚合 | — |
| Backbone Block 1-3 | C/2C/4C 通道, 4/6/6 层 | 多尺度 2D 特征提取 | — |
| Upsample 1-3 | 转置卷积 + Concat, 6C 输出 | 多尺度特征融合 | — |
| 分类头 | Focal Loss | 目标类别预测 | |
| 回归头 | SmoothL1 | 3D 框位置/尺寸/角度 | |
| 方向头 | Softmax CE | 消除 180° 方向歧义 |
总损失函数:
4.3 关键代码
核心代码为 Pillar Feature Extraction(柱体特征提取)。
(来源:pillar_vfe.py,OpenPCDet 标准实现,原始代码发布于 nutonomy/second.pytorch)
📄 点击展开 PillarVFE.forward 代码
def forward(self, batch_dict, **kwargs): |
实验与分析
5.1 主要结果
| 方法 | 模态 | 速度 (Hz) | BEV mAP | 3D mAP |
|---|---|---|---|---|
| VoxelNet | LiDAR | 4.4 | 58.25 | 49.05 |
| SECOND | LiDAR | 20 | 60.56 | 56.69 |
| F-PointNet | LiDAR+Img | 5.9 | 65.39 | 57.35 |
| AVOD-FPN | LiDAR+Img | 10 | 64.11 | 55.62 |
| PointPillars | LiDAR | 62 | 66.19 | 59.20 |
关键发现:
- PointPillars 仅用 LiDAR 即超越所有融合方法(除行人类的 F-PointNet)
- 推理速度 62 Hz,是 VoxelNet 的 14 倍、SECOND 的 3 倍
- 方向估计(AOS)在所有类别上大幅领先
5.2 消融实验:验证三个洞察
| 实验 | 配置 | BEV mAP | 验证洞察 |
|---|---|---|---|
| VoxelNet 编码(0.16²m²) | 学习编码(3D) | 74.0 | 洞察 2 |
| PointPillars 编码(0.16²m²) | 学习编码(2D) | 72.6 | 洞察 1、2 |
| MV3D 编码(0.16²m²) | 固定编码 | 71.0 | 洞察 2 |
| PIXOR 编码(0.16²m²) | 固定编码 | 71.3 | 洞察 2 |
| 分辨率 0.12²→0.28² | 速度/精度权衡 | 73.7→~68 | 洞察 3 |
注:消融使用 KITTI val 集,mAP 为 BEV 三类 Moderate 均值。VoxelNet 编码略优(+1.4),但速度慢数个数量级。
5.3 性能瓶颈分析
- 行人和骑行者:由于点云稀疏(远距离仅几个点),小目标检测仍然困难
- 类别混淆:行人和骑行者容易互相误分类;行人易与电线杆等细长垂直结构混淆
- 三维编码信息丢失:柱体 MaxPool 丢失了部分 z 轴细节(vs VoxelNet 的 3D 编码差 1.4 mAP)
5.4 失效场景分析
- 远距离/严重遮挡目标:点云极度稀疏时容易漏检
- 行人-骑行者混淆:两类形状相似,单靠点云难以区分
- 细长垂直结构误检:电线杆、树干等容易被误判为行人
- 标注缺失/GT 遗漏:部分场景中 PointPillars 正确检测但 GT 缺失
工程实践
6.1 训练配置
Backbone: 2D CNN (Block1/2/3 + Upsample concat) |
6.2 复现要点
- GT 采样增强:从全数据集构建 GT 数据库,每帧随机插入 15/0/8 个 car/ped/cyc GT 样本,对性能提升约 3 mAP
- 柱体大小选择:0.16m² 是精度和速度的最佳平衡点;0.28m² 可达 105 Hz 但精度下降
- 单独训练:car 和 ped/cyc 分开训练两个网络(因检测范围和 anchor 尺寸不同)
- 点特征增强:添加
(到柱体中心偏移)额外贡献 +0.5 mAP - NMS 策略:使用轴对齐 NMS(IoU 0.5),性能与旋转 NMS 相当但快很多
6.3 性能优化方向
精度提升:
- 引入多帧时序融合(利用连续帧点云密度更高)
- 柱体内使用更深 PointNet 或引入注意力机制(代价:编码时间增加)
速度优化:
- 使用 TensorRT 部署可获得 45.5% 加速(PyTorch 42.4 Hz → TensorRT 62 Hz)
- 增大柱体尺寸至 0.28m² 可达 105 Hz(精度略降)
研究启示
7.1 可迁移的思想
- 柱体化范式消除 3D 卷积瓶颈:任何需要处理 3D 点云的任务都可以考虑先投影到 BEV 伪图像,用 2D 卷积替代 3D 卷积
- BEV 伪图像是 LiDAR 与 Camera 特征对齐的天然空间:BEVFusion 等后续工作正是在 BEV 空间融合两种模态
- 学习编码 > 固定编码:端到端可学习的特征编码比手工特征更具泛化性
7.2 方法局限
- 柱体 MaxPool 丢失 z 轴细节,对需要精确高度信息的场景(如低矮障碍物)不利
- 仅在 KITTI 上验证,未在大规模数据集(如 nuScenes、Waymo)上评估
- 检测头使用传统 SSD anchor-based 方案,后续 CenterPoint 用 anchor-free 的中心点检测取得更好效果
7.3 技术影响
- 奠定 LiDAR BEV 检测范式:BEV 伪图像 + 2D 检测头成为 LiDAR 检测的标准流程
- CenterPoint 的基础:CenterPoint 沿用 PointPillars 的柱体化编码,替换 SSD 头为中心点热力图头
- BEVFusion 的 LiDAR 分支:BEVFusion 直接使用 PointPillars 风格编码生成 LiDAR BEV 特征
- 工业部署标杆:62 Hz 的实时性能使 PointPillars 成为自动驾驶量产系统的常用 LiDAR 检测方案